
يأتي إطلاق الإصدار الثاني من منصة أندرويد المعيارية ليحدث نقلة نوعية في قدرة الذكاء الاصطناعي على إدارة وتطوير المهام البرمجية المعقدة التي تتطلب أياماً أو حتى أسابيع، متجاوزاً بذلك مجرد الإصلاحات البسيطة للأكواد إلى آفاق تحليلية أكثر شمولاً.
- ✅ يركز الإصدار Android Bench 2.0 على المهام المعقدة التي تستغرق أياماً لإنجازها مثل بناء التطبيقات من الصفر.
- ✅ الانتقال من التقييم الثنائي (نجاح/رسوب) إلى نظام تقييم مستمر وشامل يعتمد على الوظائف والدقة البصرية.
- ✅ تحقيق نماذج مثل GPT-6 صدارة الاختبارات بنسبة نجاح بلغت 28% في هذه النسخة المتقدمة.
- ✅ إبراز قدرة الذكاء الاصطناعي على كتابة أكواد جديدة بكفاءة أعلى مقارنة بإعادة هيكلة الأكواد البرمجية الحالية.
تطور ملحوظ في تقييم مهام المطورين عبر Android Bench
تواصل جوجل تطوير منصتها الخاصة بالاختبارات المعيارية، حيث تستمر اليوم بالكشف عن الإصدار 2.0 الذي يعكس مدى تطور قدرة الذكاء الاصطناعي على التعامل مع مهام التطوير البرمجي المعقدة للغاية.
بينما كان الإصدار الأول يركز على التعديلات التدريجيّة في مستودعات الأكواد الحالية مثل إصلاح الأخطاء البرمجية الصغيرة، يستهدف Android Bench 2.0 المهام ذات التعقيد الكبير التي تتطلب من المهندس البشري عدة أيام أو ربما أسبوعاً كاملاً لإنجازها، كإضافة ميزات جديدة بالكامل، وبناء التطبيقات من الصفر، وتحويل التطبيقات متعددة المنصات إلى نظام أندرويد.
هذا التحول الجديد تطلب اعتماد تقييمات ودرجات أكثر دقة ودقة لا تقتصر فقط على النجاح أو الرسوب؛ حيث تنتقل جوجل من نظام التقييم الثنائي إلى نظام التقييم المستمر:
نحن نحسب معدل الإنجاز هذا من خلال مزيج من العوامل مثل الوظائف، والدقة البصرية، وتجنب الانحدارات أو المشكلات الجانبية. كما نطبق عقوبات تسجيل موضوعية على أي انحرافات عن تعليمات التقييم أو القيود الهيكلية.
قامت جوجل بتقييم نماذج ذكاء اصطناعي متعددة تشمل Gemini 3.7/3.8 Flash، وOpenAI GPT-6، وAnthropic Fable 5.1، وKimi K3، وQwen 3.8 Max. ويتصدر نموذج GPT-6 Astra قائمة الاختبارات المعيارية بنسبة نجاح بلغت 28% (مقارنة بنسب بلغت 90% باستخدام النهج السابق الأقل تعقيداً).
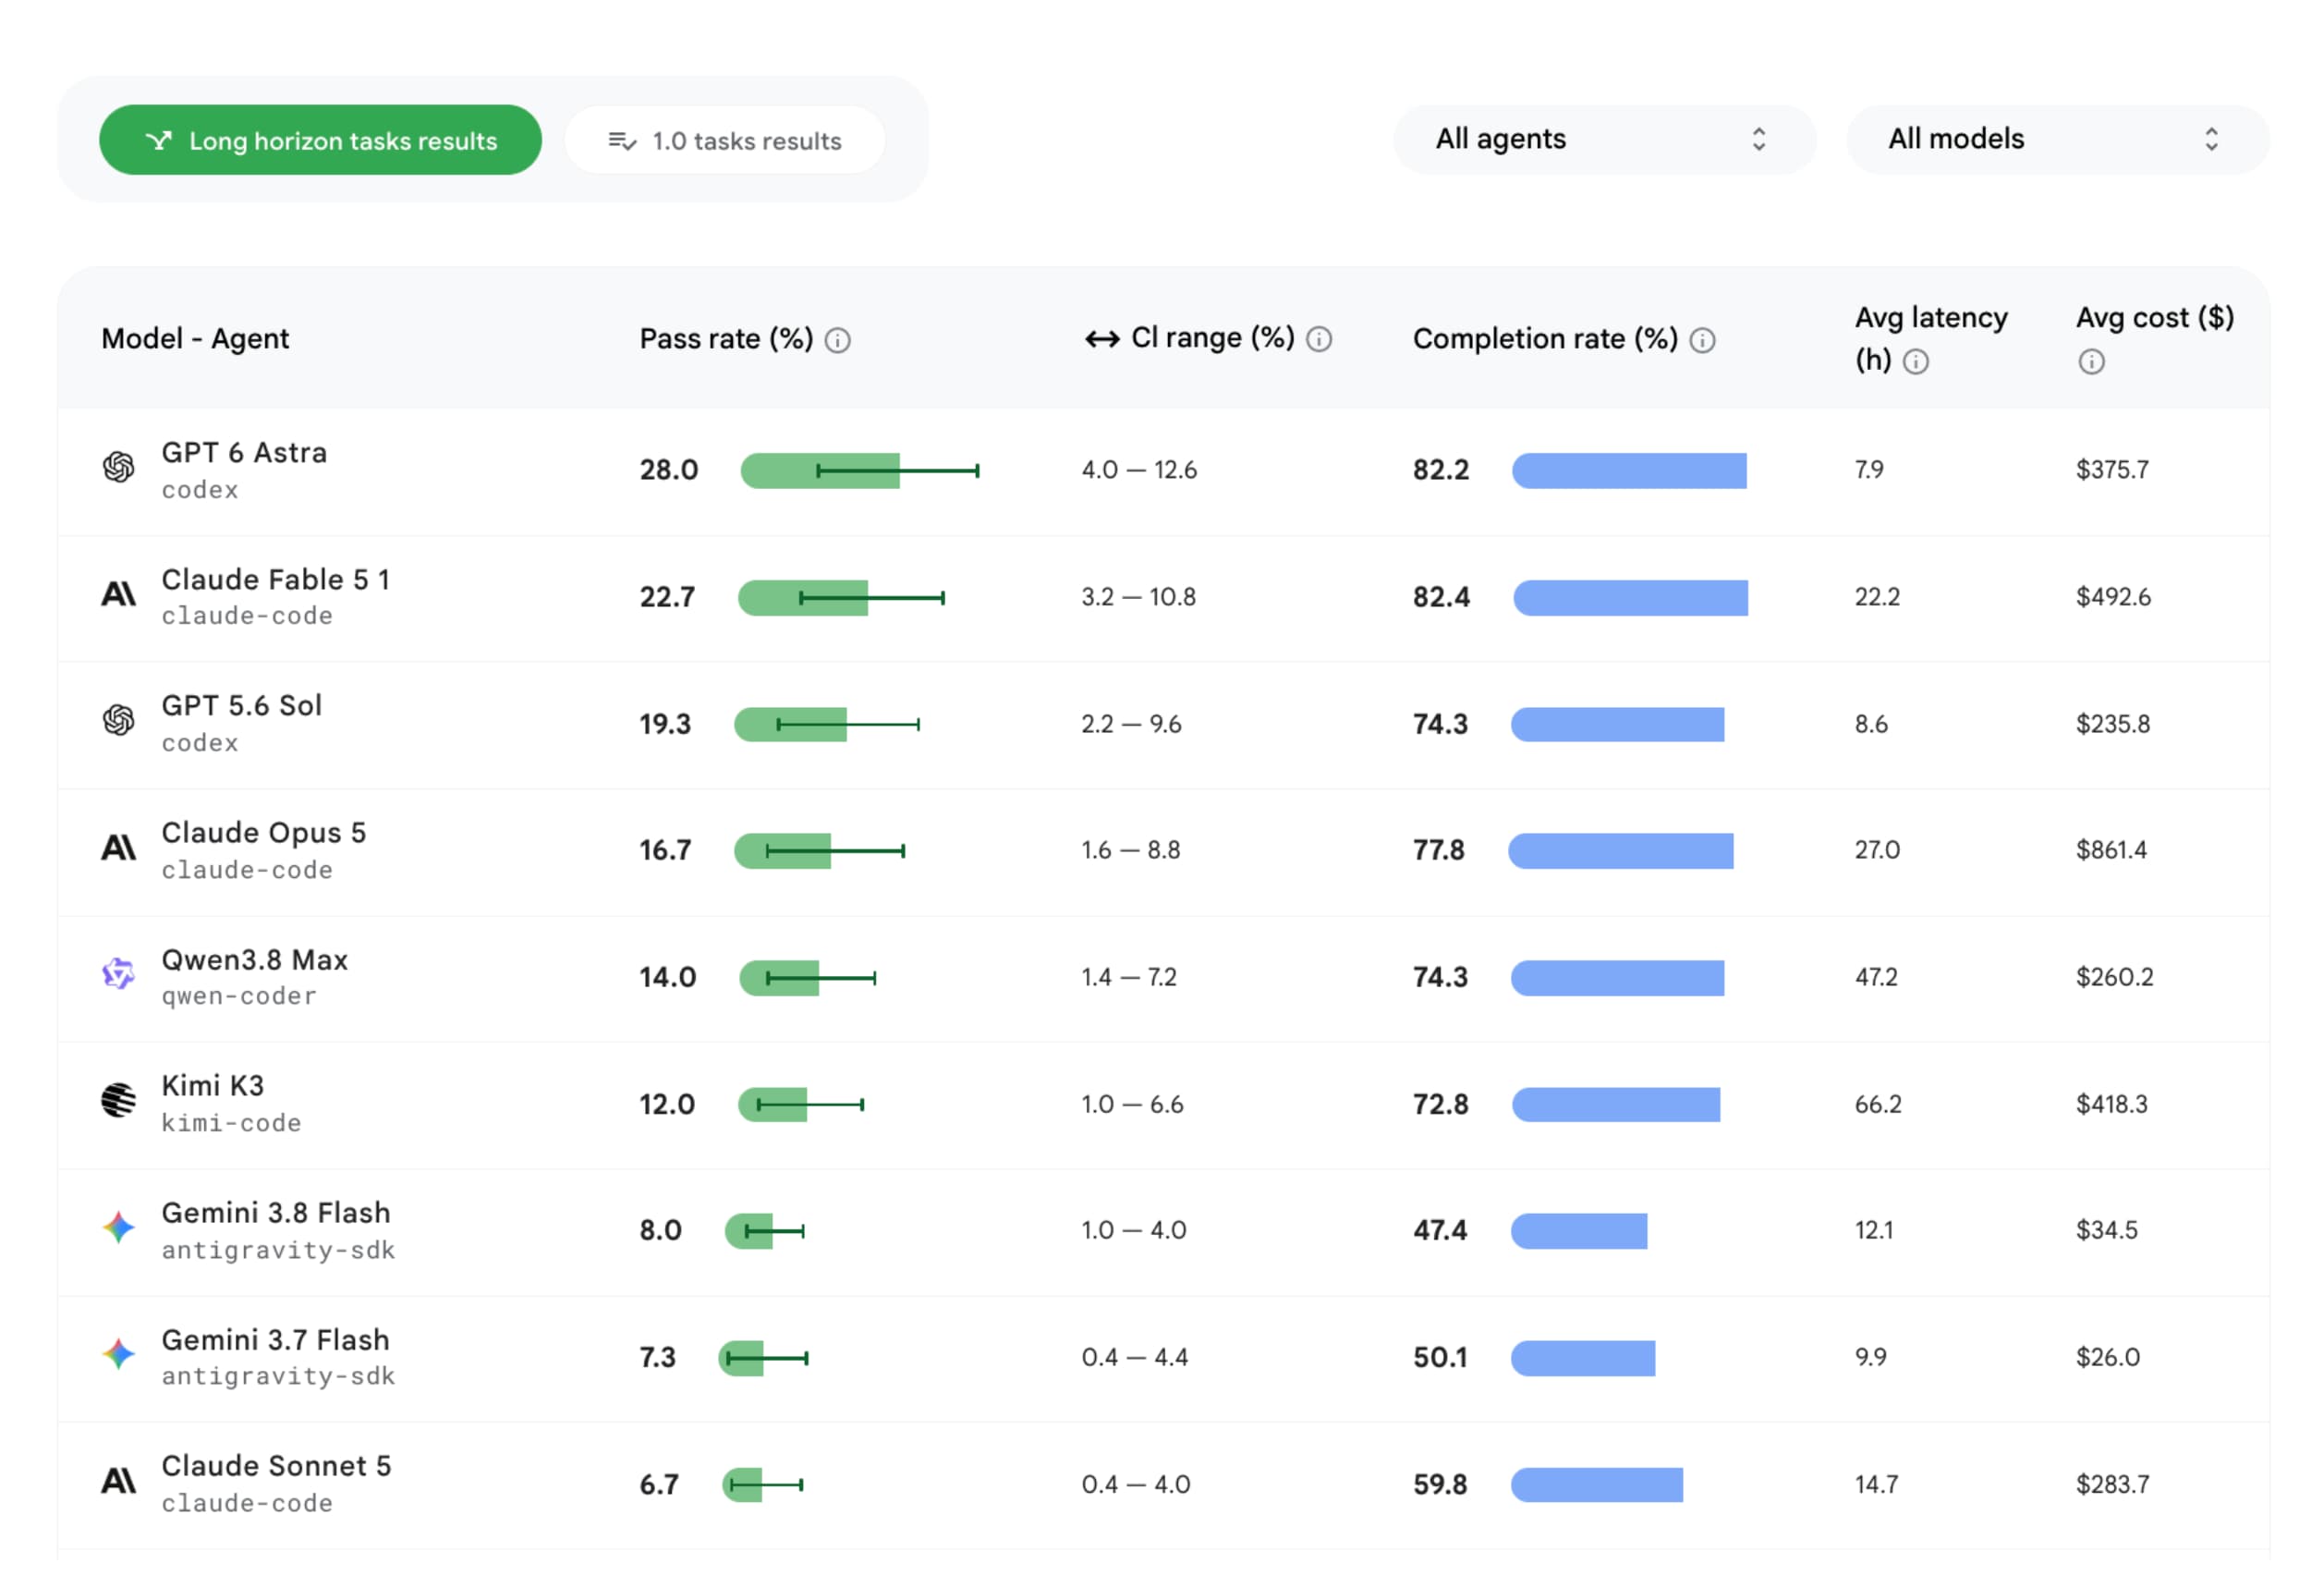
شاركت جوجل رؤى هامة، مثل كون عملية "نقل التطبيقات متعددة المنصات إلى أندرويد تظل تحدياً مفتوحاً؛ حيث لا تصل أي من النماذج إلى معدل نجاح بنسبة 100%، بينما تحققت أعلى النماذج الرائدة معدل إنجاز أقصاه 80%".
- يؤدي الذكاء الاصطناعي وظيفة أفضل في كتابة أكواد برمجية جديدة بدلاً من إعادة هيكلة الأكواد الحالية. وتصبح عمليات إعادة الهيكلة والهجرة أكثر تعقيداً لأن النجاح يعتمد على التعقيد المعماري وليس على حجم الكود.
- تظهر النماذج قدرات قوية في عمليات التحويل الحتمية والراسخة، مثل تحويل لغة جافا إلى كوتلن، أو استبدال مكتبة Retrofit بـ Ktor، أو إدخال طبقة ViewModel.
- تعاني النماذج وتواجه صعوبات عندما تتطلب المهام التحقق في وقت التشغيل (مثل رسوم حقن التبعيات المفقودة)، أو عندما تتضمن تغييرات هيكلية جذرية في إطار العمل، أو تواجه فجوات معرفية مع مكتبات لم يتم إصدارها بعد.
مع تقييمات الوكلاء، قامت منصة Android Bench بتشغيل "وكلاء من مزودي النماذج المعنية"، مثل نموذج Gemini 3.8 Flash على منصة Google Antigravity وننموذج GPT-5.6 Sol مع Codex. وتقول جوجل إن "تصميم بيئة العمل يؤثر بشكل إيجابي على نتائج المطورين"، مع وجود خطط لدى Android Bench لتضمين تركيبات مختلفة من النماذج والوكلاء في المستقبل.
ما هو الهدف الرئيسي من إصدار Android Bench 2.0؟
يهدف الإصدار الثاني إلى قياس قدرة نماذج الذكاء الاصطناعي على التعامل مع المهام البرمجية المعقدة وطويلة المدى التي تتطلب أياماً أو أسابيع من العمل لإنجازها، مثل بناء التطبيقات الكبيرة من الصفر.
كيف يتم تقييم أداء النماذج في الإصدار الجديد؟
انتقلت المنصة من التقييم الثنائي البسيط إلى نظام تقييم مستمر وشامل يقيس الوظائف، والدقة البصرية، ويفرض عقوبات على الانحراف عن التعليمات الهيكلية.
أي النماذج تفوق في اختبارات Android Bench 2.0؟
تصدر نموذج GPT-6 Astra قائمة الاختبارات المعيارية محققاً نسبة نجاح وصلت إلى 28% في هذه المهام المعقدة للغاية.
هل ينجح الذكاء الاصطناعي في إعادة هيكلة الأكواد القديمة بسهولة؟
لا، يجد الذكاء الاصطناعي صعوبة أكبر في إعادة الهيكلة مقارنة بكتابة أكواد جديدة كلياً، حيث يعتمد النجاح في ذلك على التعقيد المعماري للنظام.
🔎 في الختام، يمثل إطلاق Android Bench 2.0 خطوة محورية نحو فهم أعمق للقدرات الحقيقية للذكاء الاصطناعي في قطاع تطوير البرمجيات المعقدة، مما يمهد الطريق لابتكار أدوات برمجية أكثر اعتمادية وذكاءً للمطورين في المستقبل القريب.
قم بالتعليق على الموضوع