
أبرز النقاط الرئيسية:
- ✅ قامت جوجل بتحديث قائمة اختبارات أندرويد (Android Bench) لتقييم أداء نماذج الذكاء الاصطناعي في المساعدة على البرمجة.
- ✅ تصدر نموذج Claude Sonnet 5.5 القائمة بمعدل نجاح بلغ 40%، بينما جاء نموذج Gemini 4 Argon في المركز الخامس متأخراً عن المنافسين.
- ✅ أضافت التحديثات الأخيرة مستويات التكاليف ونقاط الاستدلال ومقارنات دقيقة لمساعدة مطوري أندرويد في اختيار النموذج الأنسب.
قامت جوجل بتحديث قائمة اختبارات أندرويد (Android Bench) المخصصة لتوضيح مدى كفاءة نماذج الذكاء الاصطناعي في تقديم المساعدة بمهام برمجة أندرويد، حيث أظهرت النتائج أن نموذج Gemini 4 Argon يتأخر بفارق واضح خلف أحدث نماذج Claude وGPT.
تم تقديم قائمة اختبارات أندرويد في وقت سابق من هذا العام كطريقة سريعة لمطوري أندرويد لمعرفة نماذج الذكاء الاصطناعي الأنسب لمساعدتهم في البرمجة، استناداً إلى اختبار أجرته جوجل. يأخذ هذا الاختبار بعين الاعتبار جوانب استخدام الذكاء الاصطناعي الخاصة ببرمجة أندرويد وأفضل الممارسات المتبعة في تطوير التطبيقات. ومع استمرار جوجل في إجراء اختباراتها وتصنيف النماذج الجديدة، قامت أيضاً بإدراج متوسط التكلفة كجزء من معيار التقييم لتمكين المطورين من اتخاذ القرار الأنسب لاحتياجاتهم.
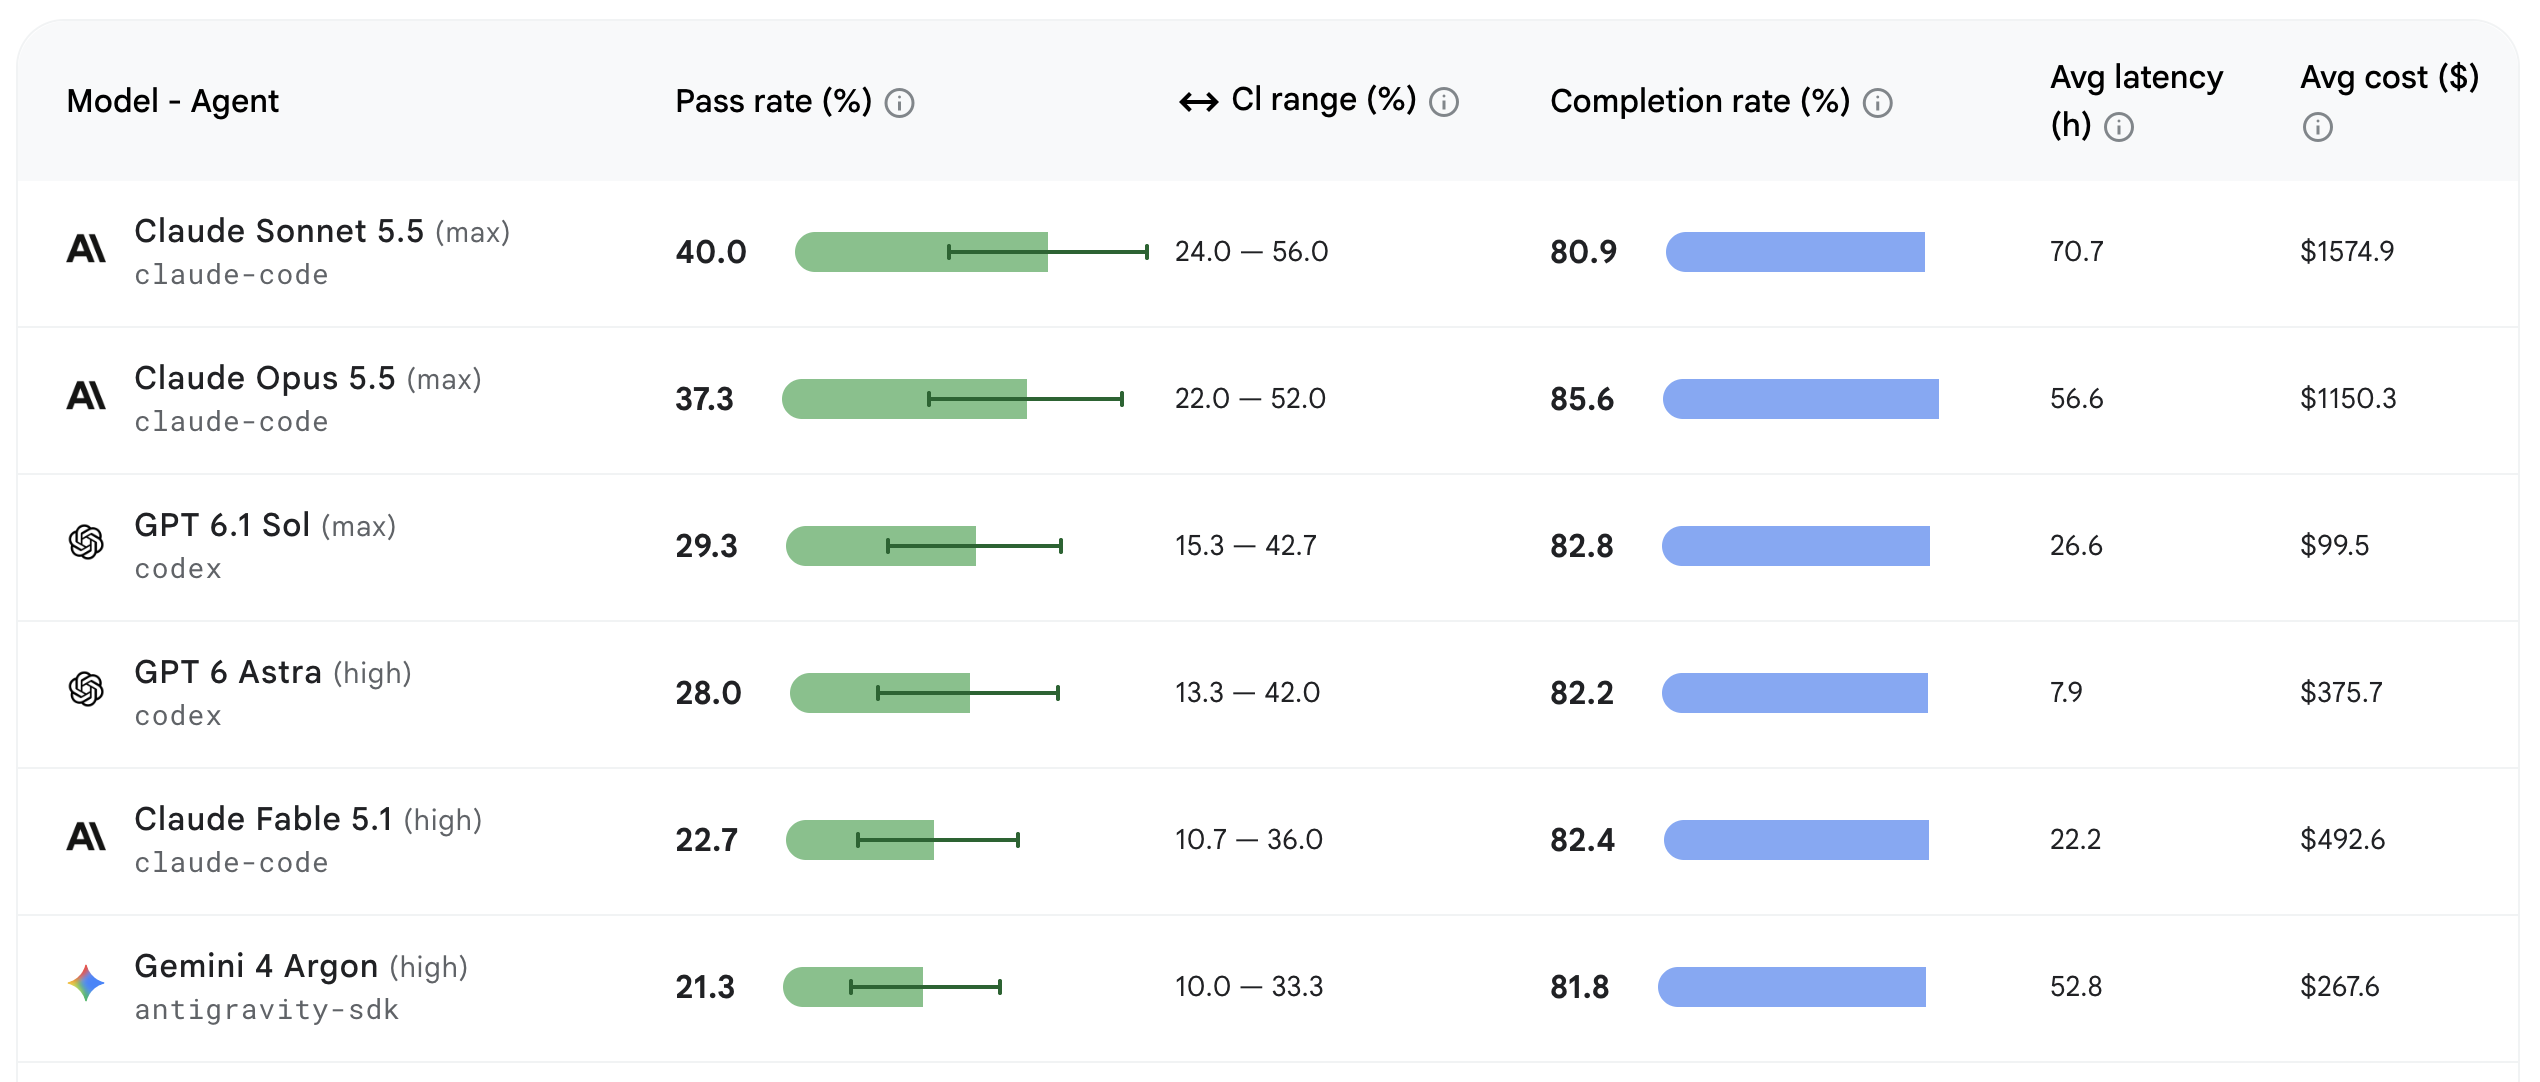
مع تحديث 26 أكتوبر، أضافت جوجل مستوى الاستدلال المستخدم لكل نموذج، بالإضافة إلى تضمين نتائج نماذج OpenAI مثل GPT-6 Sol وGPT-6.1 Sol، ونماذج Claude Sonnet 5 وClaude Sonnet 5.5، إلى جانب نموذج Gemini 4 Argon الخاص بجوجل.
يتصدر القائمة حالياً نموذج Claude Sonnet 5.5 بمعدل نجاح يبلغ 40% ومعدل إكمال بنسبة 80.9%. بينما جاء نموذج Claude Opus 5.5، الذي أُضيف إلى القائمة في أوائل أكتوبر، في المركز الثاني.
قد يكون نموذج GPT-6.1 Sol من OpenAI هو الإضافة الأكثر إثارة للاهتمام هنا، حيث حقق معدل نجاح بنسبة 29.3% ومعدل إكمال بنسبة 82.8%، ولك بتكلفة تبلغ 99.50 دولاراً فقط مقارنة بتكلفة Claude التي بلغت 1,574.90 دولاراً لصالح حصوله على المركز الأول.
ولكن Gemini 4 Argon التابع لجوجل هو الذي سجل ظهوراً مخيباً للآمال إلى حد ما، حيث استقر في المركز الخامس متخلفاً عن النماذج الرائدة الأخرى. فهو يتأخر حتى عن نموذج Claude Fable 5.1 مسجلاً معدل نجاح ضئيل يبلغ 21.3%، ومعدل إكمال بنسبة 81.8%، ومتوسط تكلفة يصل إلى 267.70 دولاراً.
في تقرير صدر بعد فترة قصيرة من إعلان جوجل عن نموذج Gemini 4 Argon، ادعت بعض المصادر الداخلية أن النموذج "يكافح للتعامل مع بعض المهام البرمجية"، على الرغم من أن جوجل دافعت عن قدراته.
مزيد من الأخبار حول الذكاء الاصطناعي:
- تصميم Gemini Live الجديد يسهل إضافة السياق إلى المحادثات
- Claude Duet هو وكيل الذكاء الاصطناعي الاستباقي من Anthropic لمنافسة Muse وDots من OpenAI
- مشتركو Gemini AI Plus يفقدون الوصول إلى نماذج Pro الشهر القادم
ما هو اختبار Android Bench الخاص بجوجل؟
هو معيار أداء تم إدخاله لمساعدة مطوري أندرويد في تقييم مدى ملاءمة نماذج الذكاء الاصطناعي المختلفة لمساعدتهم في كتابة وفحص الأكواد البرمجية الخاصة بتطبيقات أندرويد بناءً على اختبارات واضحة ومعايير دقيقة.
أي النماذج يتصدر قائمة تقييم أداء برمجة أندرويد حالياً؟
يتصدر القائمة حالياً نموذج Claude Sonnet 5.5 بمعدل نجاح بلغ 40% ونسبة إكمال تصل إلى 80.9% متفوقاً على باقي النماذج المنافسة.
كيف كان أداء نموذج Gemini 4 Argon مقارنة بالنماذج الأخرى؟
سجل نموذج Gemini 4 Argon التابع لجوجل أداءً متأخراً نسبياً مستقراً في المركز الخامس خلف نماذج Claude وGPT، بمعدل نجاح بلغ 21.3% فقط.
ما هي تكلفة استخدام النماذج في اختبارات أندرويد؟
تتفاوت التكاليف بشكل كبير بين النماذج؛ فبينما سجل نموذج GPT-6.1 Sol تكلفة اقتصادية بلغت حوالي 99.50 دولاراً، وصلت تكلفة نماذج أخرى مثل Claude إلى أكثر من 1,500 دولار.
🔎 في الختام، يُظهر التحديث الأخير لاختبارات أندرويد تفوقاً ملحوظاً لنماذج مثل Claude وGPT في مهام البرمجة المتخصصة، مما يضع ضغوطاً إضافية على جوجل لتحسين أداء نماذجها المستقبلية وتجاوز التحديات التي تواجه Gemini 4 Argon في تلبية تطلعات مطوري الهواتف الذكية.
قم بالتعليق على الموضوع